Colaboração editorial. Este artigo foi escrito por Sophie Ale, content writer no Letras Diferentes, e publicado em parceria com a DevPlus. O conteúdo é original e exclusivo; nossa equipe fez a revisão técnica, validou os exemplos de código e acrescentou uma nota com o equivalente em .NET ao final. Agradecemos à Sophie pela iniciativa.
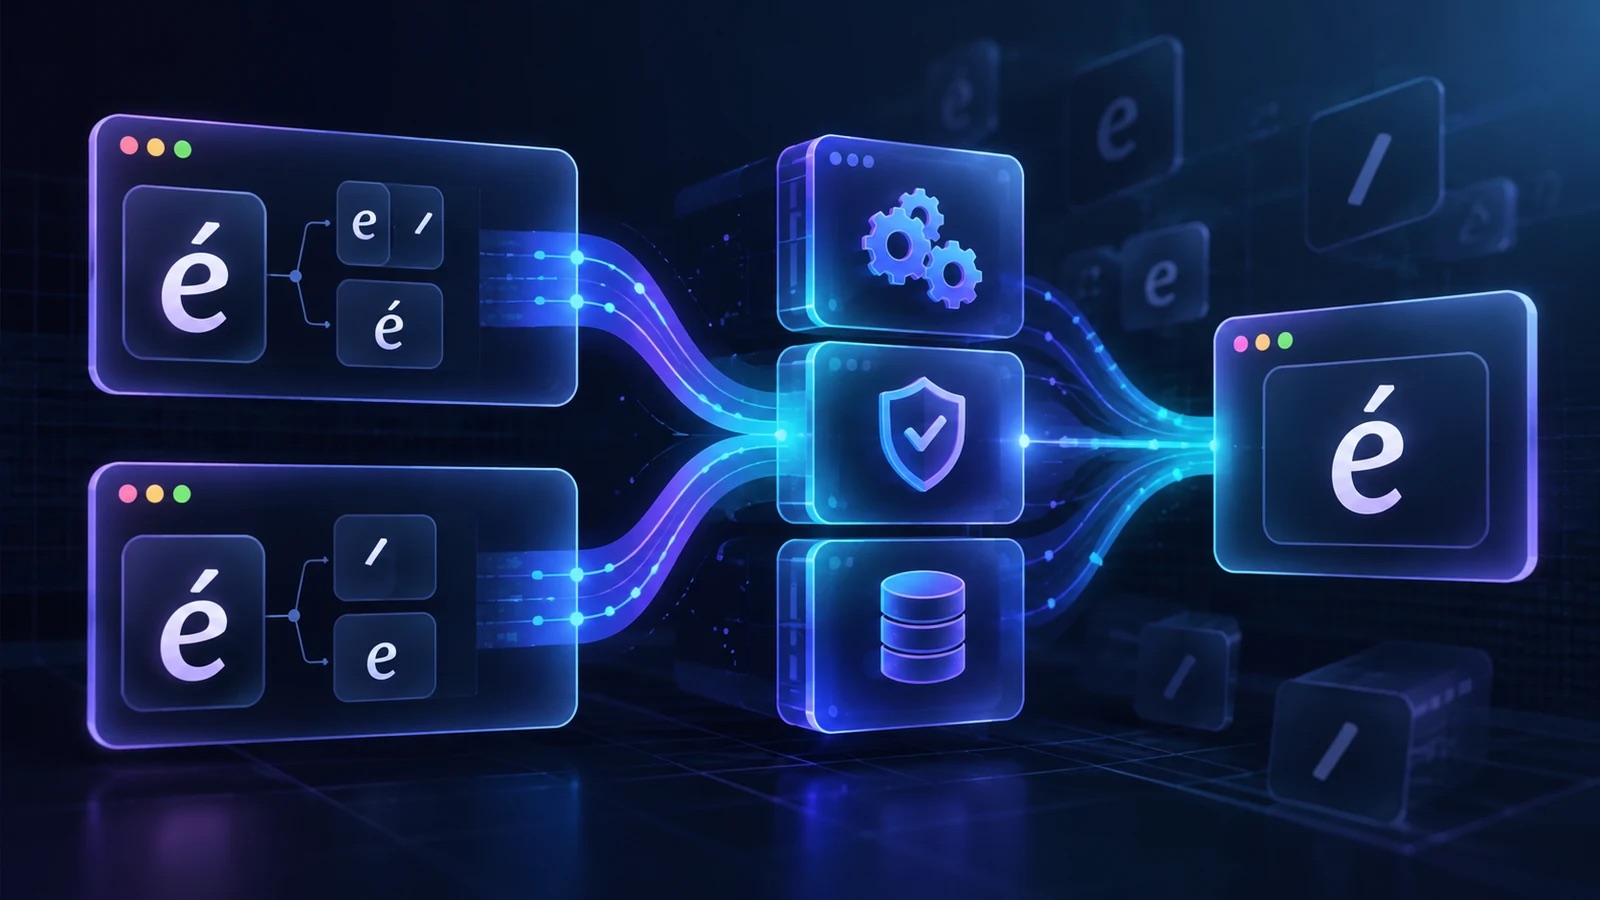
Imagine uma API de cadastro recebendo o apelido “café” de duas interfaces. Os valores parecem idênticos na tela; o primeiro contém U+00E9 (é), enquanto o segundo termina com U+0065 (e) seguido de U+0301 (acento agudo combinante). Uma comparação direta pode tratá-los como strings diferentes. Se a regra de unicidade depender dessa comparação, o sistema poderá aceitar duas entradas que o produto considera equivalentes.
Isso não é um defeito do Unicode. É uma decisão de engenharia que ainda não foi tomada: em que condições dois textos devem representar o mesmo valor? Quando uma aplicação aceita letras diferentes e símbolos decorativos em nomes públicos, preservar a aparência escolhida pela pessoa pode ser correto; a chave usada para identificar uma conta, porém, exige regras próprias de comparação. Essas regras precisam existir antes da validação, do índice único e do contrato de integração.
O mesmo texto visível pode ter representações diferentes
const composto = "café";    // café: U+00E9
const decomposto = "café"; // cafe + U+0301

console.log(composto === decomposto); // false
console.log(composto.normalize("NFC") === decomposto.normalize("NFC")); // true
A normalização NFC transforma sequências canonicamente equivalentes em uma representação comum. As duas strings acima passam a ser iguais para comparação exata. Essa garantia vem do algoritmo de normalização definido no UAX #15, não de uma heurística visual, e está disponível em JavaScript por meio de String.prototype.normalize().
Há um detalhe operacional: igualdade canônica, igualdade sem diferenciar maiúsculas e minúsculas e busca sem acentos são políticas distintas. NFC não transforma “A” em “a”, nem faz “ação” corresponder automaticamente a “acao”. O banco, o mecanismo de busca e a API devem aplicar a política apropriada ao mesmo campo.
Escolher NFC ou NFKC exige entender o campo
| Forma | O que faz | Quando considerar |
|---|---|---|
| NFC | Decompõe e recompõe por equivalência canônica. | Texto comum, nomes exibidos e valores que precisam de igualdade canônica. |
| NFD | Faz decomposição canônica. | Processamento interno especializado; não deve ser adotada por hábito. |
| NFKC | Aplica equivalência de compatibilidade e recompõe. | Alguns identificadores com política de caracteres explicitamente definida. |
| NFKD | Aplica decomposição de compatibilidade. | Fluxos específicos em que a perda de distinções é intencional. |
A diferença não é apenas técnica. Em NFKC, por exemplo, “①” (U+2460) passa a “1”. Para um código de produto, isso talvez seja desejável; em um texto histórico ou na exibição de um apelido, pode eliminar uma distinção escolhida pelo autor. Aplicar NFKC indiscriminadamente a todo payload é uma forma de alterar dados sem contrato.
O contrato de texto deve ser definido por domínio, não por endpoint
Uma política útil começa na modelagem. Nome exibido, apelido único, slug e chave de integração parecem apenas strings no JSON, mas têm restrições e efeitos diferentes.
| Campo | Decisão de projeto | Risco a testar |
|---|---|---|
| Nome exibido | Normalizar em NFC e preservar a escrita válida escolhida pela pessoa. | Perda de símbolos, espaços significativos ou grafemas. |
| Apelido único | Definir a chave de unicidade e a política de colisão; aplicar a mesma regra no armazenamento. | Duas representações canônicas registradas como contas diferentes. |
| Slug público | Estabelecer um repertório permitido e regras de transformação documentadas. | Mudança de URL ou colisão após transformação. |
| ID de integração | Preferir formato de máquina explícito, versionado e validado na borda. | Serviços discordando sobre o valor recebido. |
Um campo pode demandar duas representações: texto para exibição e chave derivada para a operação que precisa comparar. A chave não deve ser criada por regras improvisadas em cada serviço. A especificação precisa declarar a forma Unicode, a comparação, o repertório permitido e a política para colisões.
Um fluxo de entrada que pode ser auditado
Considere este encadeamento para um campo com unicidade:
- Decodificar os bytes conforme o protocolo.
- Verificar tipo e limites.
- Normalizar.
- Aplicar validação de domínio.
- Consultar e persistir usando uma chave definida.
Em operações concorrentes, a garantia final de unicidade deve estar em uma restrição atômica do armazenamento (um índice único, por exemplo), não em um teste “existe antes de inserir”.
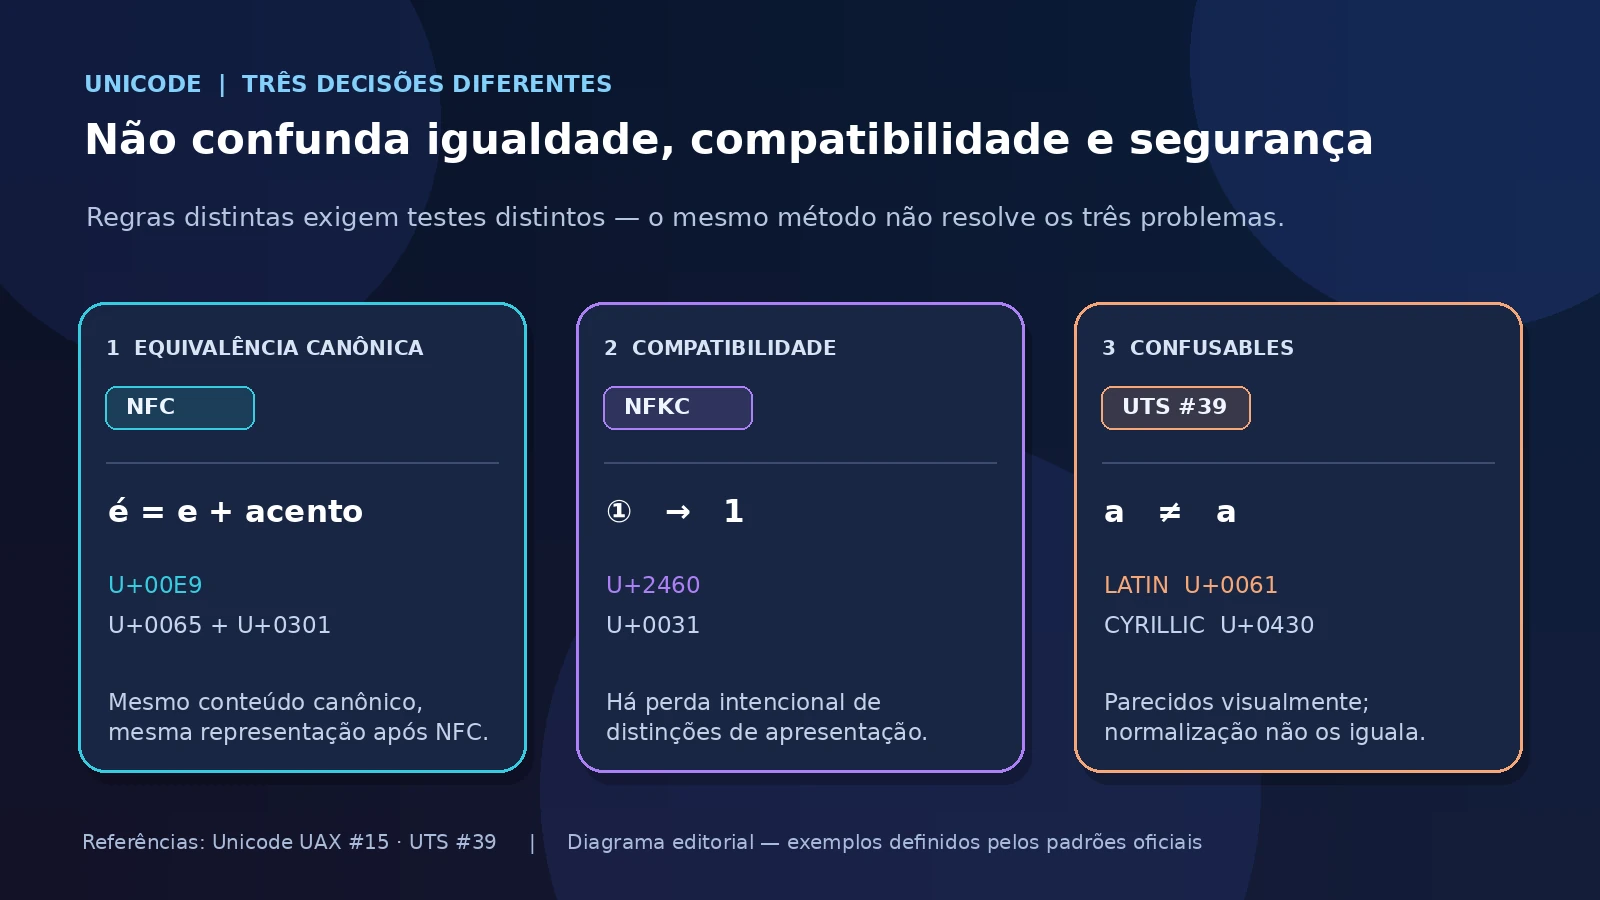
Figura 1 — Três perguntas diferentes: equivalência canônica, compatibilidade e caracteres visualmente confundíveis.
A ordem também importa na migração: normalizar uma coluna antiga sem examinar as colisões pode criar conflitos que não existiam na representação anterior. Primeiro inventarie os valores, calcule chaves candidatas, revise ambiguidades e só então ajuste índices e escrita de novos dados.
Exemplo em JavaScript: validação consciente de um apelido
No exemplo a seguir, a regra de produto é específica: retirar espaços nas extremidades, manter o valor em NFC e aceitar de 3 a 24 grafemas percebidos pelo usuário. Ela não promete unicidade sem diferenciar caixa, não remove acentos e não detecta tentativas de impersonação.
const segmentador = new Intl.Segmenter("pt-BR", {
  granularity: "grapheme",
});

function prepararApelido(valor) {
  if (typeof valor !== "string") {
    throw new TypeError("Apelido deve ser texto");
  }

  const exibicao = valor.trim().normalize("NFC");
  const grafemas = [...segmentador.segment(exibicao)].length;

  if (grafemas < 3 || grafemas > 24) {
    throw new RangeError("Apelido deve ter entre 3 e 24 grafemas");
  }

  return {
    exibicao,
    chaveCanonica: exibicao, // igualdade canônica e sensível a caixa
  };
}
A contagem usa Intl.Segmenter porque string.length em JavaScript mede unidades de código UTF-16, não “caracteres visíveis”. Uma sequência como ”👩🏽💻” possui várias unidades internas (length igual a 7 e quatro code points), mas corresponde a um único cluster de grafemas estendido segundo as regras do UAX #29. Para limites de bytes, buffers ou tamanho de coluna, essa contagem não substitui a medição exigida pelo armazenamento.
Se a aplicação usa login por apelido ou pesquisa sem diferenciar caixa, a chaveCanonica do exemplo deve ser substituída por outra política expressamente definida, com testes específicos para idioma e collation. Não confunda toLowerCase() com um mecanismo completo e universal de comparação Unicode.
Matriz de testes: o que precisa passar antes do deploy
A matriz abaixo é um ponto de partida para testes unitários, de integração e de contrato. Os resultados esperados dizem respeito à política declarada; não são uma recomendação universal para todos os campos.
| Cenário / entrada | Resultado esperado | Camada que deve verificar |
|---|---|---|
"café" × "café" | Mesma chave depois de NFC. | Função de normalização e índice de unicidade. |
"①" × "1" | Continuam diferentes em NFC; colidem em NFKC. | Testes que impedem NFKC inadvertida. |
"Ana" × "ana" | Continuam diferentes sob igualdade exata NFC. | Política de comparação sensível a caixa. |
"ação" × "acao" | Não se igualam apenas por NFC. | Camada de busca, se houver equivalência sem acentos. |
"a" latino (U+0061) × "а" cirílico (U+0430) | Continuam diferentes em NFC e NFKC; exigem avaliação de risco visual. | Política de identificadores e segurança. |
"👩🏽💻" | Um grafema em segmentação padrão; vários code points. | Validador de comprimento visual. |
| Duas inserções concorrentes da mesma chave | Uma delas deve falhar com conflito de unicidade. | Banco de dados, em teste de integração. |
| Payload recebido de outro serviço | Mesma chave de comparação em ambos os lados, conforme contrato. | Testes de contrato entre produtores e consumidores. |
Um teste adicional merece atenção em sistemas existentes: executar o pipeline contra registros reais em ambiente controlado, procurando múltiplos valores que se tornariam a mesma chave. O objetivo é descobrir colisões antes de impor uma regra nova, sem publicar dados de usuários em logs ou relatórios.
Normalização não resolve caracteres visualmente confundíveis
A letra latina “a” (U+0061) e a letra cirílica “а” (U+0430) podem parecer iguais em muitas fontes. Não são equivalentes por NFC; NFKC também não as torna iguais. Esse é outro problema: os confusables, abordados pelo UTS #39 — Unicode Security Mechanisms.
Um sistema com perfis públicos pode precisar de detecção de misturas suspeitas de alfabetos, reserva de nomes sensíveis ou revisão adicional. Isso não justifica bloquear automaticamente todos os nomes multilíngues: misturar scripts pode ser legítimo. A política deve ser proporcional ao risco e documentar como tratar falsos positivos.
Também vale separar o controle visual do controle de identidade. Detectar letras parecidas não substitui autenticação, autorização, revisão de nomes reservados ou medidas contra abuso.
Banco de dados, integrações e observabilidade: onde a política costuma se perder
Persistência e pesquisa
Aplique a mesma função de geração de chave antes de inserir e consultar. Documente se a comparação é feita pela aplicação, por collation do banco ou por ambas; teste o comportamento efetivo do motor e da versão implantada. Se o nome exibido é preservado separadamente, não use uma busca flexível como critério implícito de unicidade.
Contratos entre serviços
Inclua a forma de normalização e os critérios de comparação no contrato do campo, especialmente quando diferentes linguagens e bancos participam do fluxo. “String UTF-8” descreve o transporte, não estabelece sozinho a identidade de dois valores Unicode. Para identificadores, perfis de caracteres podem seguir as orientações do UAX #31.
Telemetria sem exposição desnecessária
Registre contadores para normalizações aplicadas, validações rejeitadas e conflitos de chave. Acrescente contexto operacional seguro, como serviço, endpoint e versão da política. Evite despejar apelidos, documentos ou outros campos pessoais em logs apenas para depurar a divergência. Um alerta útil acompanha mudança de taxa após o deploy, não coleciona o texto bruto de cada usuário.
Como introduzir a regra em um sistema já em produção
A adoção segura não começa com um UPDATE em massa. Primeiro, documente o contrato atual de cada campo e execute uma análise sem mutações. Depois, compare as chaves atuais com as chaves propostas, classifique colisões reais e decida como resolvê-las. Só então introduza validação na borda, testes de regressão e restrições de persistência; monitore erros e colisões na implantação gradual.
Esse processo dá ao time uma resposta verificável para quatro perguntas:
- Quais formas Unicode são aceitas?
- Quando valores são considerados iguais?
- Em que ponto ocorre a transformação?
- Como a aplicação lida com entradas que não satisfazem a regra?
Sem essas respostas, cada componente implementa sua própria versão de “mesmo texto”.
Conclusão
Unicode deixa de ser um detalhe de interface quando texto participa de identidade, consulta ou integração. A medida mais valiosa não é normalizar tudo indiscriminadamente, mas tornar explícita — e testável — a política de cada campo. Assim, a aplicação preserva a expressão legítima do usuário onde ela importa e mantém comparações previsíveis onde a engenharia exige consistência.
Nota da equipe DevPlus: e no .NET?
Como boa parte dos nossos leitores trabalha com C#, vale registrar que todas as decisões acima se traduzem diretamente para a plataforma .NET. O exemplo abaixo foi validado com .NET 10:
using System.Globalization;
using System.Text;
var composto = "café";
var decomposto = "café";
Console.WriteLine(composto == decomposto); // False
Console.WriteLine(string.Equals(composto, decomposto,
StringComparison.Ordinal)); // False
Console.WriteLine(
composto.Normalize(NormalizationForm.FormC) ==
decomposto.Normalize(NormalizationForm.FormC)); // True
var emoji = "👩🏽💻";
Console.WriteLine(emoji.Length); // 7 (unidades UTF-16)
Console.WriteLine(new StringInfo(emoji).LengthInTextElements); // 1 (grafema)
Console.WriteLine("①".Normalize(NormalizationForm.FormKC)); // 1Alguns pontos de atenção que costumamos aplicar nos projetos:
string.Normalize()sem argumento usaFormC. Chame explicitamente a forma desejada para deixar a política visível no código.- Comparações com
StringComparison.Ordinalnão normalizam. Se a chave de unicidade é canônica, normalize antes de comparar ou de gravar. - Desde o .NET 5,
StringInfo.LengthInTextElementsconta clusters de grafemas estendidos, o equivalente aoIntl.Segmenterdo exemplo em JavaScript. Em versões anteriores a contagem era diferente. - Em SQL Server e PostgreSQL, a collation da coluna define as regras de comparação (caixa, acentos e, dependendo do motor e da collation escolhida, até equivalência canônica), mas não altera o valor gravado: o banco persiste exatamente os bytes que a aplicação enviou. Normalize na aplicação antes de gravar, crie o índice único sobre a chave já normalizada e teste o comportamento real do motor e da versão em uso.
Sobre a autora
Sophie Ale é content writer na Letras Diferentes, onde pesquisa e escreve sobre Unicode, tipografia digital, caracteres decorativos, identidade online e comunicação digital. Conheça também seu perfil de autora.
Referências
- Unicode Consortium — UAX #15: Unicode Normalization Forms
- Unicode Consortium — UTS #39: Unicode Security Mechanisms
- Unicode Consortium — UAX #29: Unicode Text Segmentation
- Unicode Consortium — UAX #31: Unicode Identifiers and Syntax
- MDN — String.prototype.normalize()
- MDN — Intl.Segmenter
- Microsoft Learn — String.Normalize
- Microsoft Learn — StringInfo.LengthInTextElements